2026/09/14 11:11
OpenAI、GPT-Live-1をAPI提供 会話を続けながら別のAIに作業を委任
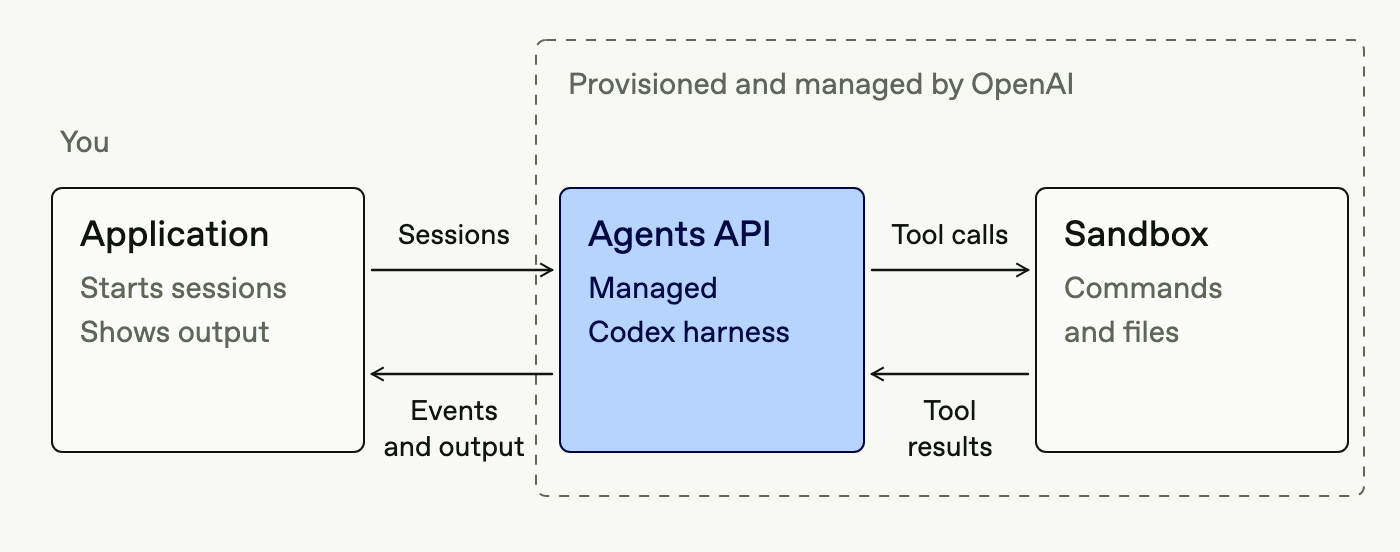
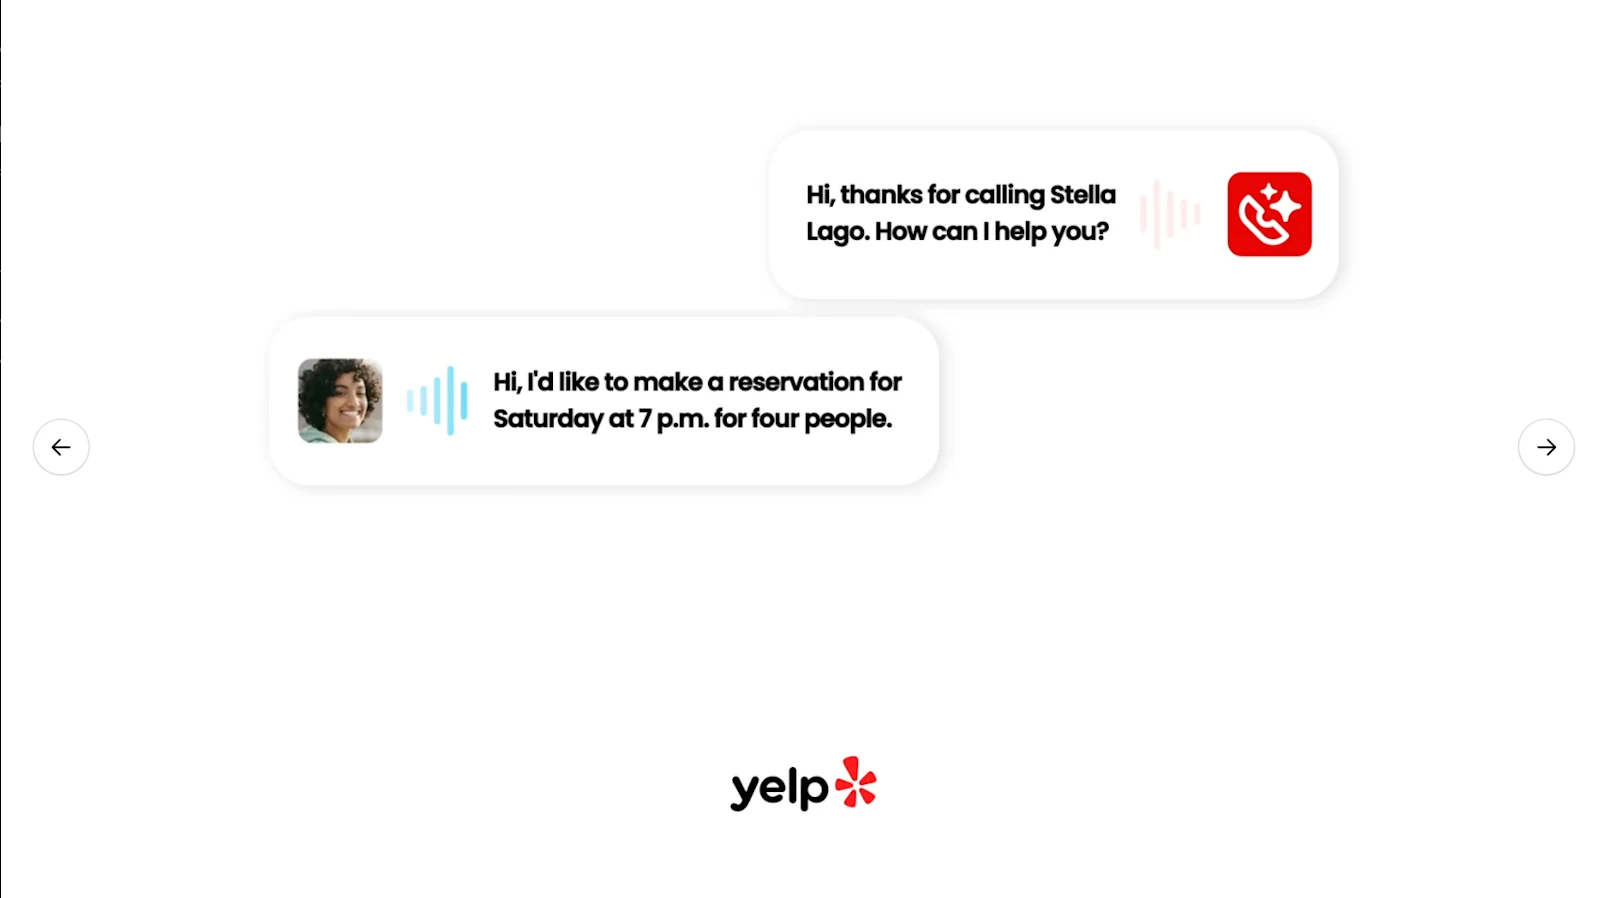
OpenAIは9月10日、音声モデル「GPT-Live-1」のAPI提供を始めました。話を聞きながら応答できるChatGPT Voiceの仕組みを、外部のアプリや電話対応にも組み込めます。音声会話を担当するモデルと、調べ物や操作を行うモデルを分けられるのが特徴です。
会話と作業を分け、応答中の追加情報も受け取る
GPT-Live-1は、音声の入力と出力を同時に扱うフルデュプレックス方式です。7月のChatGPT向け発表に続く今回のAPI公開では、開発者が声の調子や話す速さ、会話の進め方を指示し、裏側で動くモデルやツールを選べます。
たとえば注文状況を調べている間に、利用者が条件を言い足す。公式ガイドは、こうした会話を続けながら結果を待つ使い方を説明しています。音声のやり取りと、時間のかかる処理を並行して進める設計です。
声を止めることと、作業を止めることは別
接続方法には、指定したResponsesモデルへ処理を任せる方式と、アプリ側が任意のモデルやサービスを呼び出す方式があります。後者では、返ってきた結果をアプリが確認・加工してから音声側へ渡せます。
ただし、話の途中で割り込んでも、実行中の作業が自動的に取り消されるわけではありません。操作の権限、利用者への確認、作業の状態管理はアプリ側の責任です。「待って」と言われたときに何を止めるかまで、製品として設計する必要があります。
音声部分の料金は1分0.05米ドルで、セッションの長さに応じて秒単位で課金されます。裏側のモデルとツールの利用料は別です。日本語での聞き取りや遅延、実際の処理完了率は今回実測していません。